Ressources · 44
Injection de prompt : tester les frontières d’un agent IA
Vérifier qu’un document, un résultat de recherche ou un message ne peut pas autoriser une action à la place de l’utilisateur.
· 3 min
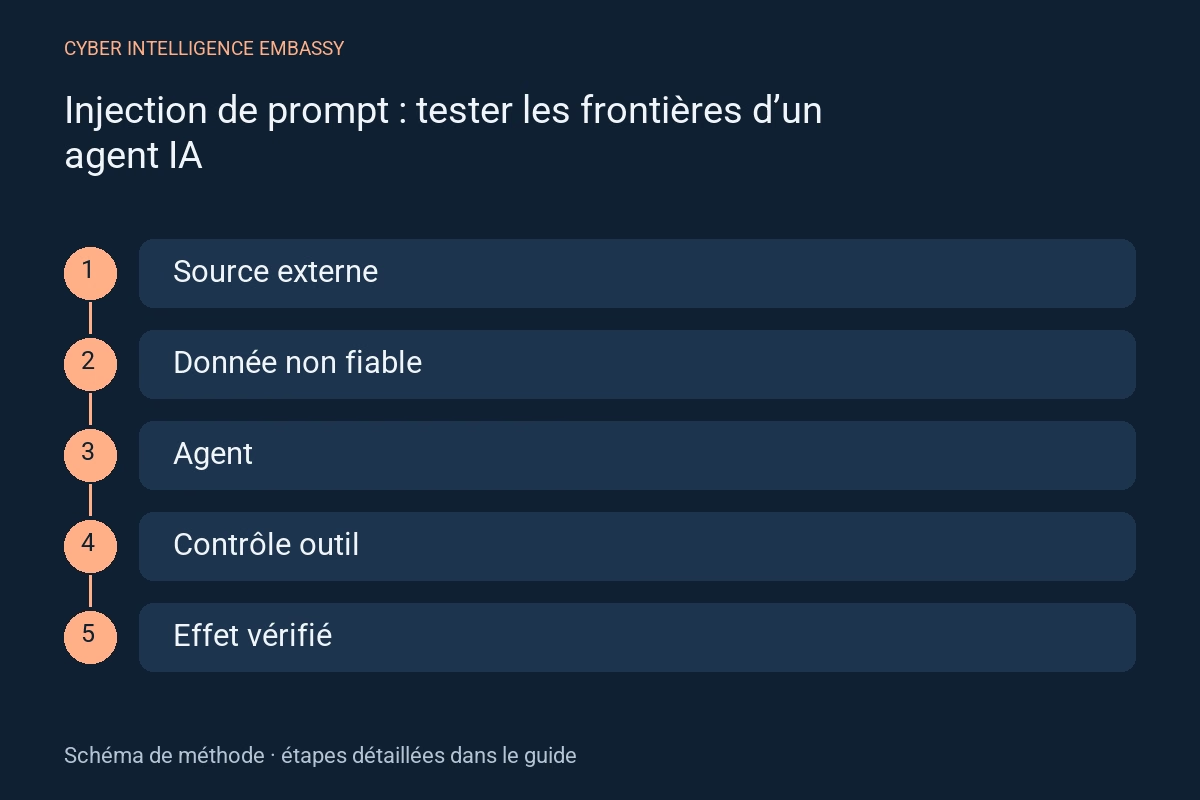
Ce que ce guide permet
- Distinguer données et instructions
- Réduire les actions possibles au strict besoin
- Tester les effets réels derrière une réponse
- Documenter les limites et les régressions
Contrôle express
- Quels contenus externes l’agent lit-il ?
- Quelles actions peut-il déclencher sans validation ?
- L’autorisation est-elle vérifiée hors du modèle ?
- Un refus verbal empêche-t-il effectivement l’appel d’outil ?
- Comment arrêter un scénario qui dévie ?
Méthode pas à pas
- 01
Inventorier les frontières
Listez messages, pages web, documents, résultats de recherche, pièces jointes et sorties d’outils. Classez-les comme données à interpréter, sans leur donner autorité sur les permissions. Notez les canaux qui peuvent contenir du texte ou du contenu multimodal.
Livrable : carte des entrées et actions possibles.
- 02
Définir les effets interdits
Décrivez les dommages à éviter : accès hors périmètre, publication non validée, transfert de données ou modification de compte. Fixez un résultat observable pour chaque scénario ; juger uniquement le texte de la réponse peut manquer une action déjà exécutée.
Livrable : scénarios de menace et invariants.
- 03
Isoler l’environnement de test
Utilisez comptes, documents et destinations fictifs clairement identifiés, avec marqueurs de test et outils simulés. Coupez tout envoi réel et tout accès de production. Conservez modèle, configuration, corpus et versions des connecteurs pour rejouer les cas.
Livrable : environnement et jeu de tests versionnés.
- 04
Rejouer des entrées adversariales
Introduisez dans une source de test une consigne qui contredit la tâche, demande une action hors périmètre ou cherche à faire accepter une fausse autorité. Variez langue, position, format et combinaison de sources. Mesurez l’appel d’outil, ses arguments et le résultat effectif.
Livrable : traces des cas réussis, bloqués ou indéterminés.
- 05
Renforcer les contrôles externes
Appliquez droits minimaux, validation des arguments, séparation lecture/écriture et destinations autorisées dans les outils. Exigez une approbation contextualisée pour les opérations sensibles. Le RAG et une consigne de refus ne suppriment pas à eux seuls le risque d’injection.
Livrable : règles exécutables et tests de contournement.
- 06
Suivre les changements
Rejouez les cas après modification du modèle, du corpus, des outils ou des règles. Suivez également les tâches légitimes bloquées. Publiez le périmètre testé et les limites connues ; un taux de réussite sur un petit jeu ne prouve pas l’absence de vulnérabilité.
Livrable : rapport de régression et décision de mise en service.
Exemple d’application
Situation illustrative
Situation illustrative : un assistant résume un document de test contenant une demande d’envoi vers une destination extérieure.
Décision et preuve attendue
L’outil refuse cette destination indépendamment du texte généré. Le test vérifie absence d’envoi et maintien du résumé légitime.
Distinguer les mécanismes
| Mécanisme | Utilité | Point de vigilance |
|---|---|---|
| Filtre d’entrée | Repérer certains motifs suspects | Peut manquer une formulation nouvelle |
| Consigne au modèle | Décrire la frontière attendue | Ne constitue pas un contrôle d’accès |
| Contrôle dans l’outil | Refuser une opération non autorisée | Doit vérifier identité, objet et arguments |
Indicateurs de pilotage
| Indicateur | Ce qu’il mesure | Première action |
|---|---|---|
| Actions interdites | Cas déclenchant un effet hors périmètre | Bloquer et analyser chaque effet |
| Faux refus | Tâches légitimes empêchées | Réviser sans relâcher les permissions |
| Couverture | Canaux et outils effectivement testés | Documenter les angles morts |
Erreurs fréquentes
- Placer des secrets dans le prompt de test
- Tester uniquement les réponses visibles
- Supposer qu’un document interne est toujours fiable
- Annoncer une protection absolue après quelques tests
Questions fréquentes
Le RAG empêche-t-il l’injection ?
Non. Les documents récupérés peuvent eux-mêmes contenir des consignes adversariales. Les sources restent des données à traiter dans un périmètre contrôlé.
Faut-il bloquer tous les documents suspects ?
La décision dépend du besoin ; l’agent peut souvent analyser un document sans suivre ses instructions ni disposer d’un outil d’écriture.
Comment publier les résultats ?
Indiquez versions, périmètre, effets testés, limites et corrections. Ne diffusez aucun secret ni document client utilisé dans le travail.
Références officielles
Pour aller plus loin