Ressources · 49
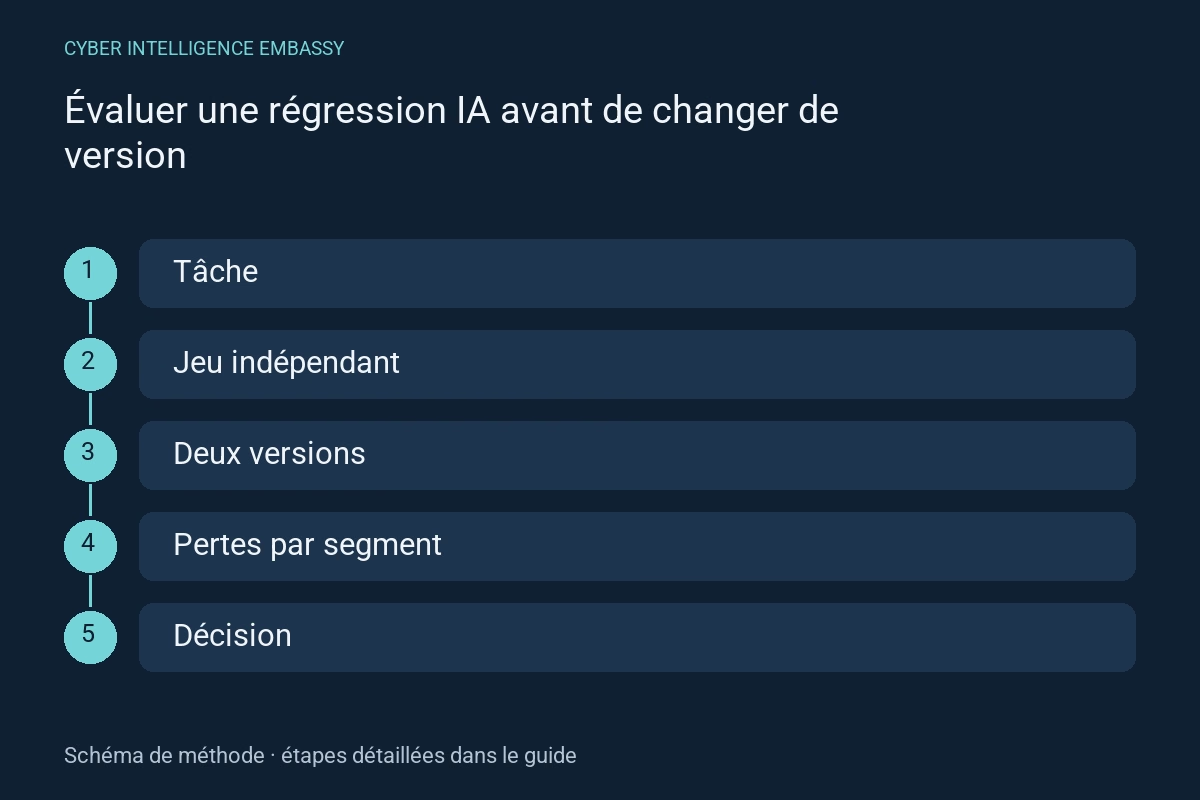
Évaluer une régression IA avant de changer de version
Comparer deux versions sur les mêmes tâches, repérer les pertes locales et décider avec des preuves plutôt qu’une moyenne.
· 3 min
Ce que ce guide permet
- Isoler le changement testé
- Préserver un jeu de référence
- Examiner les échecs par segment
- Préparer l’arrêt ou le retour arrière
Contrôle express
- Quel composant a changé ?
- Le jeu de test a-t-il servi à optimiser la nouvelle version ?
- Qui tranche un désaccord d’annotation ?
- Une moyenne masque-t-elle une erreur sensible ?
- La configuration précédente est-elle restaurable ?
Méthode pas à pas
- 01
Fixer la tâche et les refus
Décrivez résultat attendu, données autorisées et erreurs coûteuses. Séparez exactitude, utilité, refus approprié et effet d’une action. Le cadre NIST propose des mesures adaptées au contexte ; il ne délivre pas un score universel de fiabilité.
Livrable : critères et responsable de décision.
- 02
Séparer référence et découverte
Conservez un ensemble stable non utilisé pour ajuster le système. Ajoutez séparément des cas nouveaux issus de retours anonymisés : ils détectent des angles morts, mais ne doivent pas modifier silencieusement le dénominateur de comparaison.
Livrable : deux jeux versionnés et leur provenance.
- 03
Documenter l’annotation
Écrivez ce qui rend une réponse acceptable, partielle ou incorrecte. Faites relire les cas ambigus par une personne compétente et conservez le motif des désaccords. Une réponse de référence unique peut être trop restrictive pour une tâche ouverte.
Livrable : grille et cas d’arbitrage.
- 04
Comparer à conditions égales
Rejouez les mêmes entrées avec versions, paramètres, outils et sources enregistrés. Si les sorties varient, répétez les essais et rapportez cette variabilité. Distinguez défaut du modèle, donnée absente, outil indisponible et erreur du test.
Livrable : résultats appariés et traces minimisées.
- 05
Décider par famille de risque
Inspectez les pertes sur langues, types de documents et situations sensibles, même si la moyenne progresse. Fixez avant lecture des résultats les motifs d’arrêt, de correction ou de déploiement limité. Un cas grave peut justifier un refus de mise en service.
Livrable : décision, réserves et exceptions.
- 06
Rejouer après mise en service
Préparez une configuration restaurable et un responsable joignable. Confrontez les premiers retours au jeu de test, sans considérer la réussite locale comme une preuve sur tous les usages. Réexaminez les cas lorsque les données ou dépendances changent.
Livrable : suivi et procédure de retour arrière.
Fiche de travail à réutiliser
À compléter avec vos observations autorisées. Ces champs constituent une trame de travail, pas des résultats observés.
| Champ | Information à consigner |
|---|---|
| Cas et segment | Identifiant stable, langue, type de tâche |
| Attendu | Critère d’acceptation et source de référence |
| Versions A / B | Résultat, répétition, cause d’échec |
| Décision | Accepter, corriger ou arrêter ; responsable et preuve |
Exemple d’application
Situation illustrative
Exemple fictif : une mise à jour améliore les réponses courantes mais supprime la mention d’incertitude sur des documents contradictoires.
Décision et preuve attendue
Le rapport distingue ce sous-ensemble, conserve la trace des sources et suspend le déploiement sur cet usage jusqu’à une correction rejouée.
Distinguer les mécanismes
| Mécanisme | Utilité | Point de vigilance |
|---|---|---|
| Jeu stable | Comparer deux versions | Ne pas l’utiliser comme jeu d’optimisation |
| Cas nouveaux | Découvrir un angle mort | Les publier séparément du résultat historique |
| Observation en service | Voir les usages réels | Respecter droits, minimisation et contexte |
Indicateurs de pilotage
| Indicateur | Ce qu’il mesure | Première action |
|---|---|---|
| Pertes appariées | Cas auparavant acceptés devenus incorrects | Examiner chaque perte sensible |
| Désaccord d’annotation | Cas dont le jugement diverge | Préciser la règle avant de comparer |
| Couverture des segments | Situations effectivement représentées | Nommer les usages non testés |
Erreurs fréquentes
- Ajuster le système sur le test final
- Changer le jeu et la version simultanément
- Confondre juge automatique et vérité
- Accepter une perte critique parce que la moyenne monte
Questions fréquentes
Faut-il toujours un juge automatique ?
Non. Il peut accélérer le tri si sa règle est validée ; un arbitrage métier reste nécessaire pour les cas ambigus ou coûteux.
Un gain moyen suffit-il ?
Non. Comparez les cas et segments qui comptent, puis appliquez les critères décidés avant le test.
Combien d’exemples utiliser ?
Le volume dépend de la diversité et du risque. Indiquez le nombre, la provenance et les limites ; aucun petit jeu ne prouve une sûreté générale.
Références officielles
Références consultées le 2 octobre 2026. La méthode et la fiche de travail proposent des contrôles à adapter à votre contexte ; elles ne constituent pas une certification.
Pour aller plus loin
Analyses associées